Migraciones con zero downtime: la estrategia shadow table
Índice del contenido
Migraciones con zero downtime: la estrategia shadow table
Son las 2 de la madrugada, estás implementando un “simple” cambio en el tipo de columna en producción y, de repente, toda tu aplicación se cae porque el bloqueo de la tabla está tardando una eternidad. Tu teléfono empieza a vibrar con notificaciones furiosas de Slack y tú intentas explicar a tu equipo por qué la “migración de 5 minutos” lleva 30 minutos en marcha.
¿Qué es la estrategia de la shadow table?
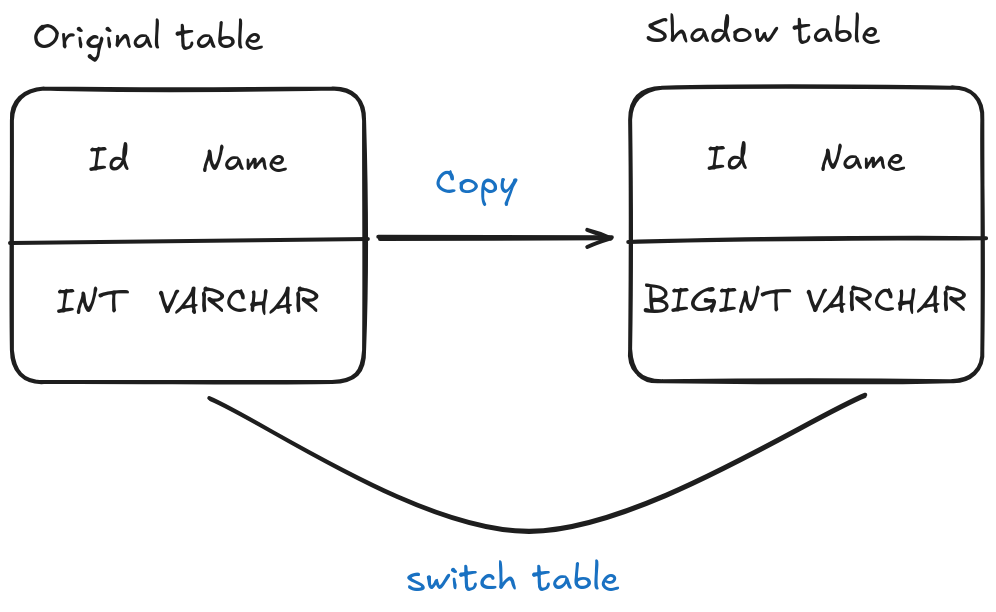
La estrategia de la shadow table (tabla sombra) consiste en tener un doble de tu tabla. En lugar de modificar la tabla original directamente, creas una nueva tabla con la estructura deseada, copias los datos poco a poco y, cuando todo está sincronizado, haces un cambio rápido entre ambas.
Este es el flujo básico:
¿Qué problema resuelve?
Las operaciones tradicionales ALTER TABLE pueden ser un problema en producción si hay miles de millones de registros. Cuando ejecutas algo como ALTER TABLE users MODIFY COLUMN id BIGINT, la mayoría de los motores de bases de datos:
- Bloquean toda la tabla mientras dura la operación.
- Bloquean todas las lecturas y escrituras mientras la reestructuran.
- Tardan horas en tablas grandes.
- Corren el riesgo de agotar el tiempo de espera y dejar la base de datos en un estado inconsistente.
La estrategia de la shadow table divide la migración de la base de datos en fragmentos más pequeños que no requieren bloqueos prolongados. Así la aplicación sigue en línea y evitas las notificaciones a las 3 de la madrugada.
¿Qué pasa con las tablas más pequeñas?
Si tu tabla no tiene millones de filas y no es crítico que la base de datos siga funcionando, puedes enviar un correo notificando a tus usuarios que la aplicación estará en mantenimiento un breve periodo.
Si es un sitio poco crítico, poner una página de “toca el césped” y hacer la migración directamente es perfectamente válido. No hace falta obsesionarse con el rendimiento en todos los casos .
En cambio, si cada segundo de bloqueo le cuesta dinero al negocio, merece la pena usar esta estrategia.
Pasos para modificar una tabla con la estrategia de shadow table
Vamos con un ejemplo práctico: cambiar el ID de usuario de INT a BIGINT porque nos acercamos al límite de 2.100 millones.
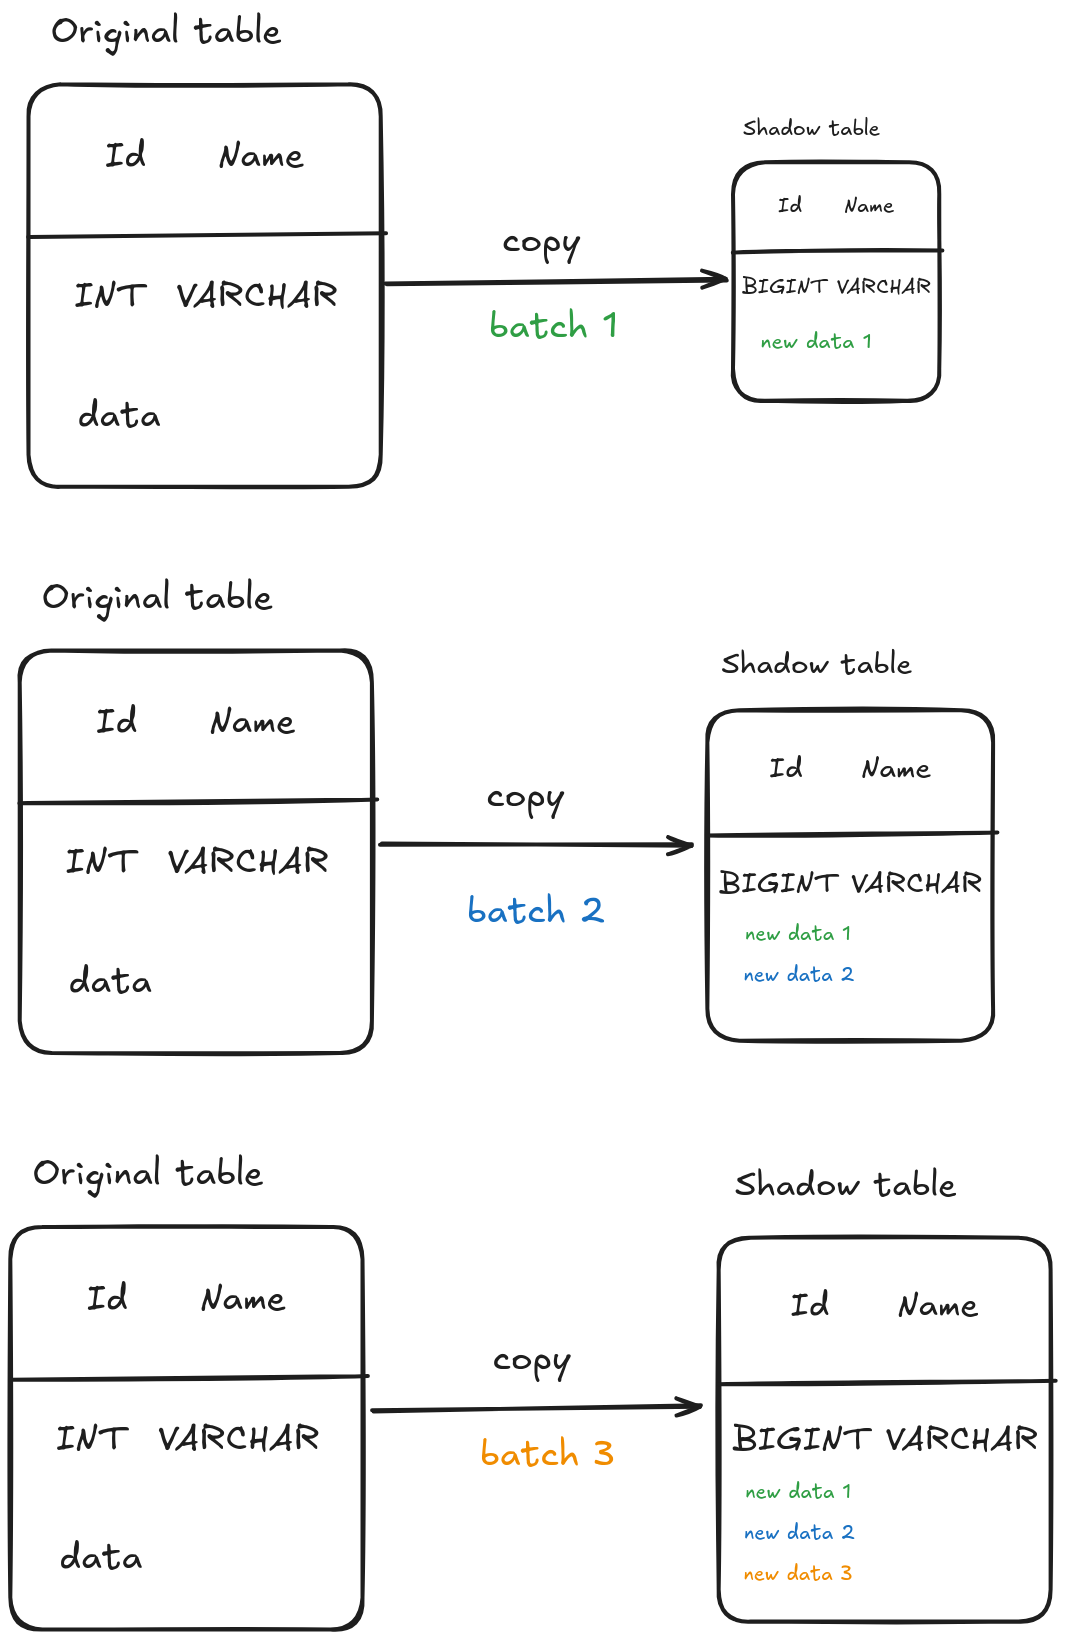
Paso 1: Crear la shadow table
Crea la nueva tabla con la estructura deseada:
-- Crear la shadow table con la nueva estructura
CREATE TABLE users_new (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    name VARCHAR(255) NOT NULL,
    email VARCHAR(255) UNIQUE NOT NULL,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP
) ENGINE=InnoDB;

-- Copiar los índices de la tabla original
CREATE INDEX idx_users_email ON users_new(email);
CREATE INDEX idx_users_created_at ON users_new(created_at);
Paso 2: Configurar la sincronización de datos
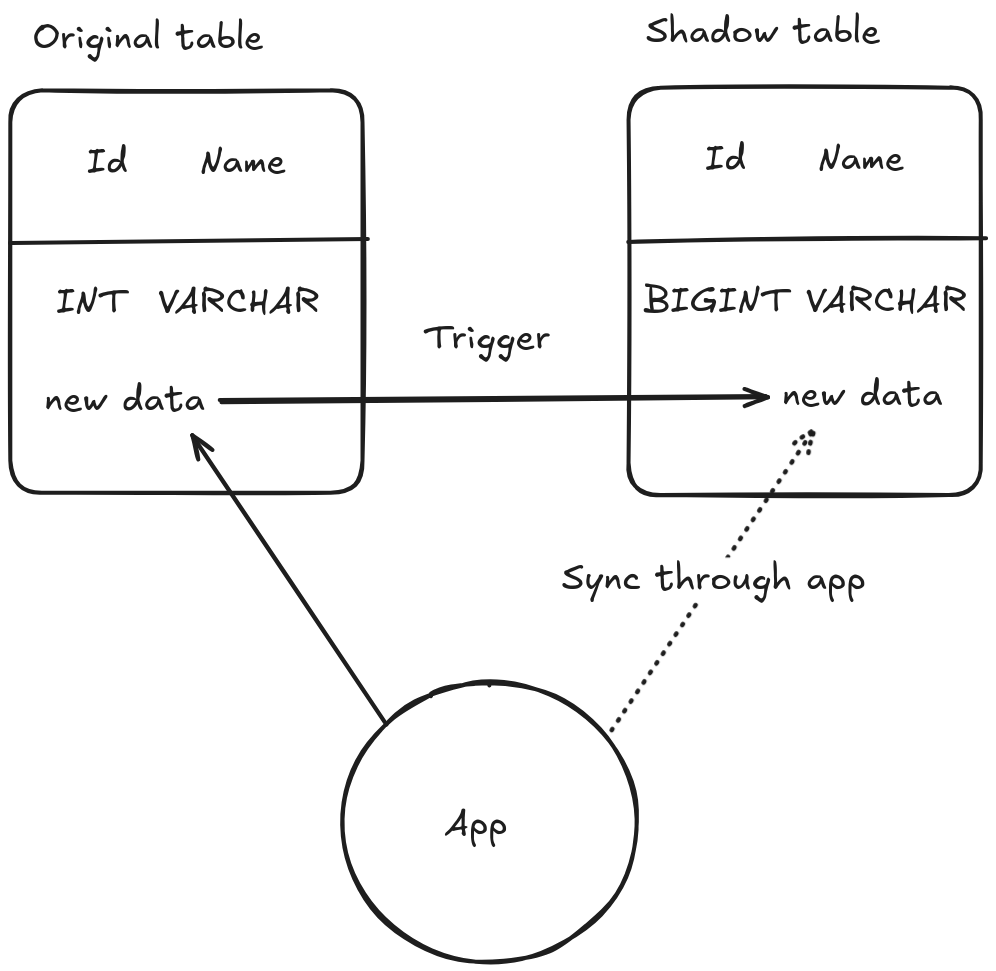
Tienes que mantener la shadow table sincronizada con la original mientras la aplicación sigue funcionando. Esto implica duplicar las escrituras entre ambas tablas. Hay dos formas de hacerlo:
Con triggers de base de datos
-- Crear triggers para mantener la sincronización
DELIMITER $$

CREATE TRIGGER users_insert_sync
    AFTER INSERT ON users
    FOR EACH ROW
BEGIN
    INSERT INTO users_new (id, name, email, created_at, updated_at)
    VALUES (NEW.id, NEW.name, NEW.email, NEW.created_at, NEW.updated_at);
END$$

CREATE TRIGGER users_update_sync
    AFTER UPDATE ON users
    FOR EACH ROW
BEGIN
    UPDATE users_new
    SET name = NEW.name,
        email = NEW.email,
        updated_at = NEW.updated_at
    WHERE id = NEW.id;
END$$

CREATE TRIGGER users_delete_sync
    AFTER DELETE ON users
    FOR EACH ROW
BEGIN
    DELETE FROM users_new WHERE id = OLD.id;
END$$

DELIMITER ;
A nivel de aplicación
Si lo prefieres, puedes hacer la sincronización desde tu código:
def update_user(user_id, changes):
    # Escritura en la tabla original
    original_db.execute("UPDATE users SET ...")

    # Escritura en la tabla sombra
    shadow_db.execute(
        "UPDATE users_new SET name=? ...",
        data['email']
    )
Paso 3: Copiar los datos existentes por lotes
El siguiente paso es copiar los datos. Nunca lo hagas todo de golpe. Lo ideal es hacerlo por lotes, aprovechando la lógica del patrón worker pool . Hazlo, si puedes, en horas de poco tráfico:
-- Copiar datos por lotes para evitar bloqueos largos
SET @batch_size = 10000;
SET @min_id = 0;
SET @max_id = (SELECT MAX(id) FROM users);

WHILE @min_id < @max_id DO
    INSERT INTO users_new (id, name, email, created_at, updated_at)
    SELECT id, name, email, created_at, updated_at
    FROM users
    WHERE id > @min_id AND id <= @min_id + @batch_size
    ON DUPLICATE KEY UPDATE
        name = VALUES(name),
        email = VALUES(email),
        updated_at = VALUES(updated_at);

    SET @min_id = @min_id + @batch_size;

    -- Pausa para dar respiro a la base de datos
    SELECT SLEEP(0.1);
END WHILE;
Paso 4: Verificar la coherencia de los datos
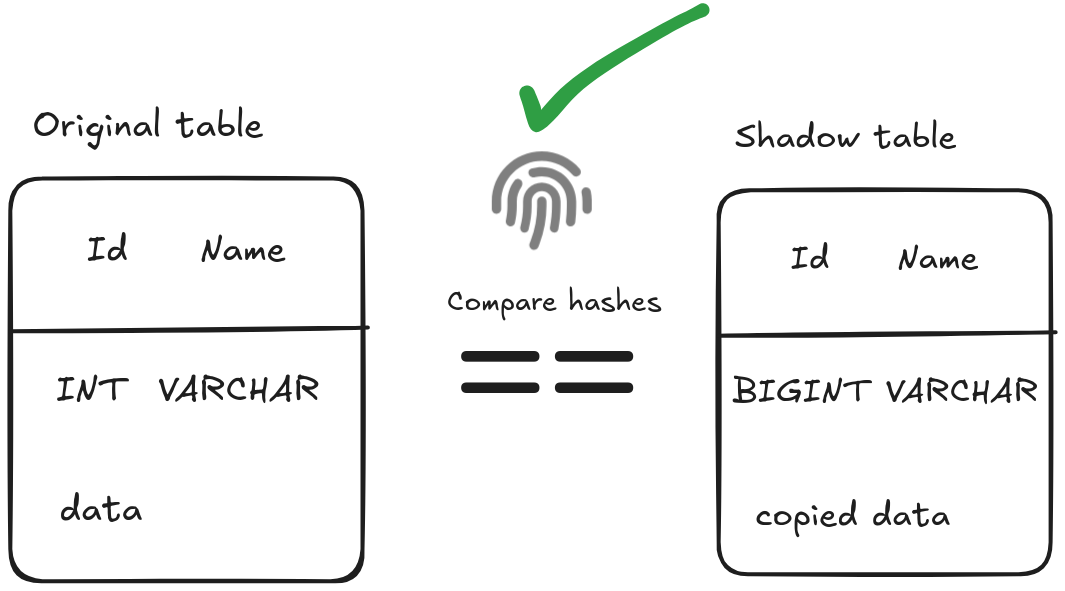
Antes de hacer el cambio, comprueba que todo coincide:
-- Comprobar el número de filas
SELECT
    (SELECT COUNT(*) FROM users) as original_count,
    (SELECT COUNT(*) FROM users_new) as shadow_count;

-- Comprobar con checksums
SELECT
    (SELECT SUM(CRC32(CONCAT(id, name, email))) FROM users) as original_checksum,
    (SELECT SUM(CRC32(CONCAT(id, name, email))) FROM users_new) as shadow_checksum;

-- Comprobar algunos registros aleatorios
SELECT * FROM users WHERE id IN (1, 1000, 50000) ORDER BY id;
SELECT * FROM users_new WHERE id IN (1, 1000, 50000) ORDER BY id;
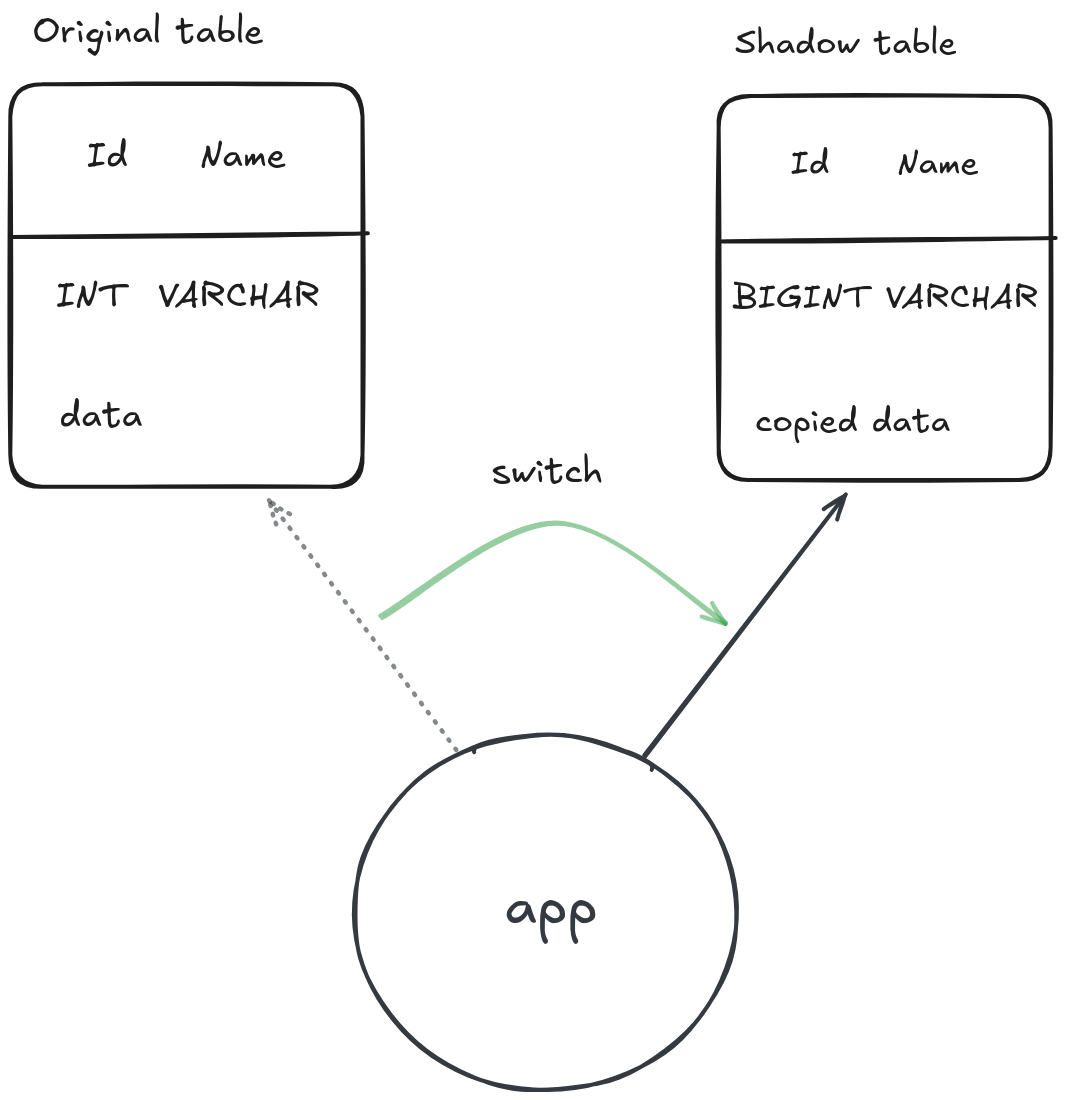
Paso 5: El cambio
El intercambio entre tablas debe ser cuestión de milisegundos:
START TRANSACTION;

-- Eliminar los triggers de sincronización
DROP TRIGGER users_insert_sync;
DROP TRIGGER users_update_sync;
DROP TRIGGER users_delete_sync;

-- Renombrar las tablas de forma atómica
RENAME TABLE users TO users_old, users_new TO users;

COMMIT;
Paso 6: Limpieza y verificación
-- Verificar que todo funciona correctamente
SELECT COUNT(*) FROM users;
SELECT * FROM users LIMIT 5;
Cuando lleves un tiempo con todo funcionando sin incidencias, puedes eliminar la tabla antigua:
DROP TABLE users_old;
Manejo de tablas con millones de QPS
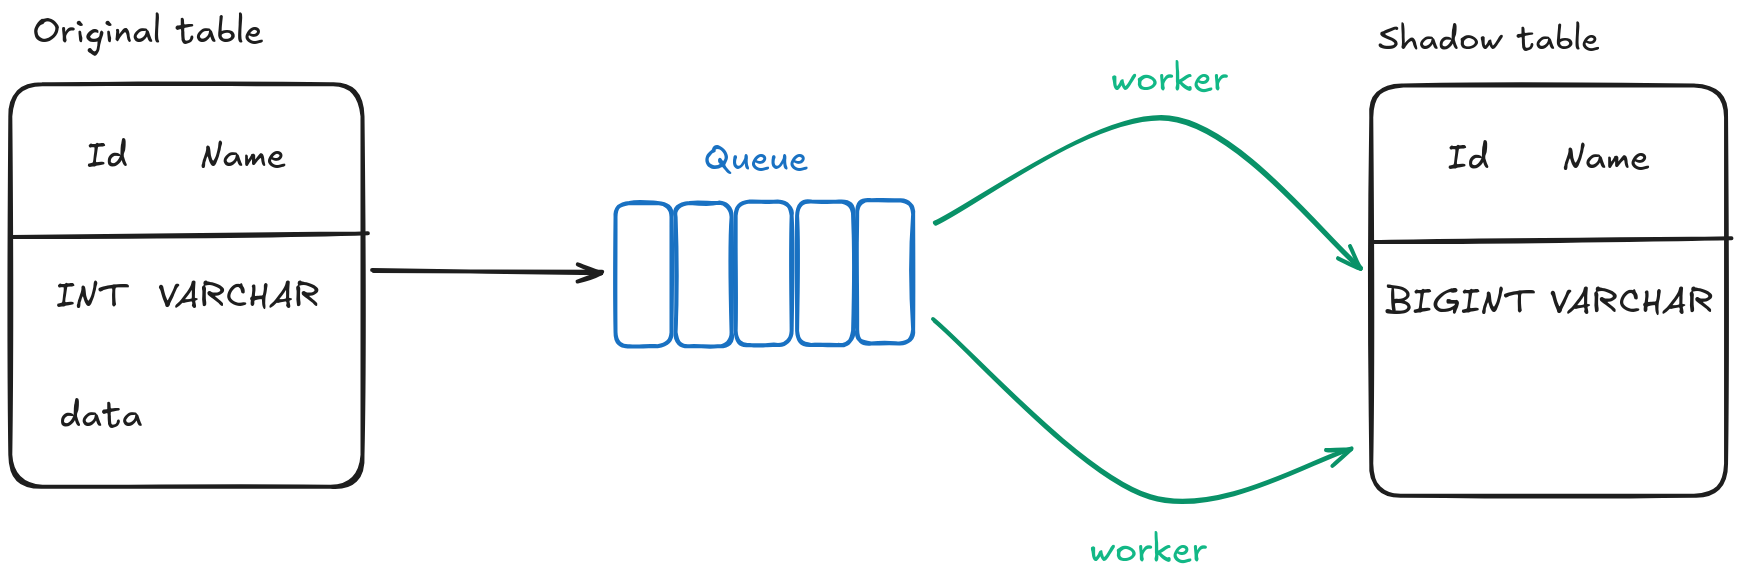
Si tienes millones de QPS o millones de usuarios simultáneos , las escrituras duales directas pueden sobrecargar la base de datos. En ese caso, puedes usar un búfer de escritura con Redis o Kafka para encolar las escrituras hacia la shadow table y dejar que se vayan sincronizando poco a poco.
Si tienes muchos cambios de nombres de columnas, también puedes usar una vista para abstraerlos:
CREATE VIEW users_combined AS
SELECT id, COALESCE(new_id, id) AS unified_id, name
FROM users_new
UNION ALL
SELECT id, id AS unified_id, name
FROM users
WHERE NOT EXISTS (SELECT 1 FROM users_new WHERE users_new.id = users.id);
Errores comunes al implementar shadow tables
- Olvidar las claves foráneas: Si otras tablas hacen referencia a la tuya, tendrás que desactivar las comprobaciones temporalmente o actualizar esas referencias con cuidado. La integridad de los datos depende de ello.
- No probar los triggers lo suficiente: Pueden fallar en silencio o comportarse de forma extraña bajo carga. Pruébalos con datos y concurrencia reales en un entorno de pruebas.
- Subestimar el retraso de sincronización: Con mucho tráfico, los triggers pueden ir por detrás. Supervisa la diferencia entre tablas y prepárate para frenar las escrituras si crece.
- Supervisión insuficiente: Necesitas visibilidad sobre el progreso de la copia, el retraso de sincronización y los errores mientras dura la migración, no cuando ya ha fallado.
- Mala planificación del rollback: Siempre ten un plan B. Si algo falla en el cambio, tienes que poder volver atrás rápido.
Manejo en sistemas distribuidos
Cuando renombres las tablas, todas las instancias de tu aplicación tienen que conocer el cambio al mismo tiempo. Para eso suele ser necesario detener el tráfico, hacer el cambio y reiniciar los servicios, o coordinarlo con un despliegue controlado.
También puedes usar feature flags, como los que explico en mi artículo sobre patrones de despliegue , para decidir desde qué tabla lee cada instancia y hacer el cambio de forma gradual.
Bases de datos con réplicas de lectura
Asegúrate de que la shadow table esté completamente replicada antes de hacer el cambio. Supervisa el lag de replicación para que el renombrado sea consistente en todas las réplicas.
Supervisión durante la transición
Durante la migración estás ejecutando dos tablas en paralelo, así que el uso de I/O subirá. Vigila el disco.
Los triggers añaden sobrecarga a cada INSERT, UPDATE y DELETE. Configura alertas si el tiempo de ejecución se dispara.
Compara el número de filas entre ambas tablas durante todo el proceso. Si la diferencia va aumentando, hay un problema de sincronización.
Restricciones únicas y claves foráneas
La shadow table debe mantener las mismas restricciones únicas que la original. Al copiar por lotes, usa INSERT ... ON DUPLICATE KEY UPDATE (o su equivalente) para evitar duplicados si hay escrituras concurrentes.
Para las claves foráneas, puedes desactivarlas temporalmente con SET FOREIGN_KEY_CHECKS=0 en MySQL, o usar comprobaciones diferidas en PostgreSQL. Ambas opciones implican un riesgo para la integridad, así que úsalas con cuidado. Otra opción es crear las claves foráneas en la shadow table y actualizar las tablas que la referencian al final.
Triggers y procedimientos almacenados
Lista todos los triggers de la tabla original. Tendrás que recrearlos en la shadow table y prestar atención al orden de ejecución: los triggers de sincronización deben ir al final, después de los triggers de lógica de negocio.
Los procedimientos almacenados que apunten a la tabla también habrá que actualizarlos tras la migración. Los sinónimos o vistas ayudan a reducir cuántos hay que cambiar.
Prueba todas estas interacciones en un entorno de staging antes de hacerlo en producción.
Verificación antes del cambio
Compara valores agregados (sumas, promedios, recuentos) entre ambas tablas. Usa checksums para confirmar que los datos coinciden fila a fila. Calcula el tamaño de muestra necesario para alcanzar el nivel de confianza que busques.
Automatiza estas comprobaciones y ejecútalas varias veces durante la migración. Herramientas como pg_checksums o consultas con COUNT(*) y hash_agg() te sirven para esto.
Plan de rollback
Si algo falla durante el cambio, lo más rápido es revertir el renombrado. Mantén la tabla original como users_old (o el nombre que prefieras) durante un tiempo tras el cambio para poder renombrarla de vuelta en cuestión de milisegundos.
En casos más complejos, puede que necesites sincronizar los datos desde la shadow table de vuelta a la original. Si mantienes triggers inversos durante la ventana de cambio, tendrás esa opción, aunque añade complejidad.
Documenta los comandos de rollback y practícalos en staging. También puedes tener un rollback a nivel de aplicación con feature flags, que en muchos casos es más rápido que tocar la base de datos.
Herramientas que te pueden ayudar
| Herramienta | Ideal para | Característica destacada |
|---|---|---|
| gh-ost | MySQL | Replicación sin triggers |
| pg_repack | PostgreSQL | Reorganización de tablas en línea |
| Liquibase | Cross-DB | Seguimiento de cambios |
| Debezium | Transmisión CDC | Integración con Kafka |
Conclusión
La estrategia de shadow table no es perfecta y hay muchas cosas que pueden salir mal. Cada base de datos y aplicación es distinta: lo que funciona para una tabla con muchas lecturas puede no funcionar para una con muchas escrituras.
Prueba todo en un entorno lo más parecido posible a producción. Si a última hora ves que algo no va bien, abortar la migración es la decisión correcta.
Otros posts recomendados
-
-
-
-
-
-